Az üzemeltethetőségi réteg
amikor egy AI-flotta vállalati szemmel is megbízható
when an AI fleet is dependable from an enterprise's point of view
An English version of this article follows below. Jump to the English version.
Egy AI-flottát nem a képességei tesznek vállalati környezetben adoptálhatóvá. A képesség a belépő. A döntést az üzemeltethetőség hozza meg: az, hogy egy szervezet tudja, mi történik a rendszerben, mi változott, és mi van akkor, ha valami elromlik. A saját flottámon most pontosan ezt a réteget építettem be: ellenőrzött mentést, tesztelt visszaállítást és metaadat-alapú audit naplót. Kevés új funkció, annál több nyugalom. Erről a fejlesztésről írok, és arról, miért ez az a réteg, amelyen egy komoly B2B tárgyalás elindul vagy elakad.
1. A funkció a belépő, az üzemeltethetőség a döntés
Amikor egy AI-rendszert egy szervezet mérlegel, a bemutató jellemzően a képességekről szól: mit tud, milyen gyors, mennyi munkát vesz le a csapatról. Ez fontos, de a tapasztalatom szerint nem itt dől el az adopció. A döntéshozó, különösen az IT-oldali döntéshozó, nem a funkción akad fenn. Két kérdés akasztja meg. Az első: ha valami elromlik, mi a protokoll? A második: mit mutatok az auditnak? Ha ezekre a rendszer nem ad konkrét, dokumentált választ, a tárgyalás technikai értelemben meg sem kezdődik.
Az én olvasatomban ez nem pesszimizmus, hanem az üzemeltetés valós logikája. Egy szervezet egy új eszközt akkor enged éles adat közelébe, ha a kockázatait kézben tudja tartani. Ezért kezdtem el a flottámon nem a következő látványos képességgel foglalkozni, hanem az alatta lévő réteggel: a mentéssel, a visszaállítással és az audittal. Ezek nem eladhatók egy demóban, viszont pontosan ezek nélkül nem lesz éles bevezetés.
2. Mentés: a megléte és a jósága nem ugyanaz
2.1 WAL-biztos pillanatkép
A flotta állapota egy SQLite adatbázisban él, amely write-ahead logging módban fut. Ez teljesítményben előny, mentésben viszont csapda. Ha ilyenkor valaki egyszerűen lemásolja a fájlokat, könnyen inkonzisztens másolatot kap: a fő adatfájl, a megosztott memória és a write-ahead napló együtt alkot egy konzisztens állapotot, és ezek nem atomi másolata törött adatbázist eredményezhet. A mentés ettől még létrejön, csak a visszaállítás bukik el rajta, jellemzően a legrosszabb pillanatban.
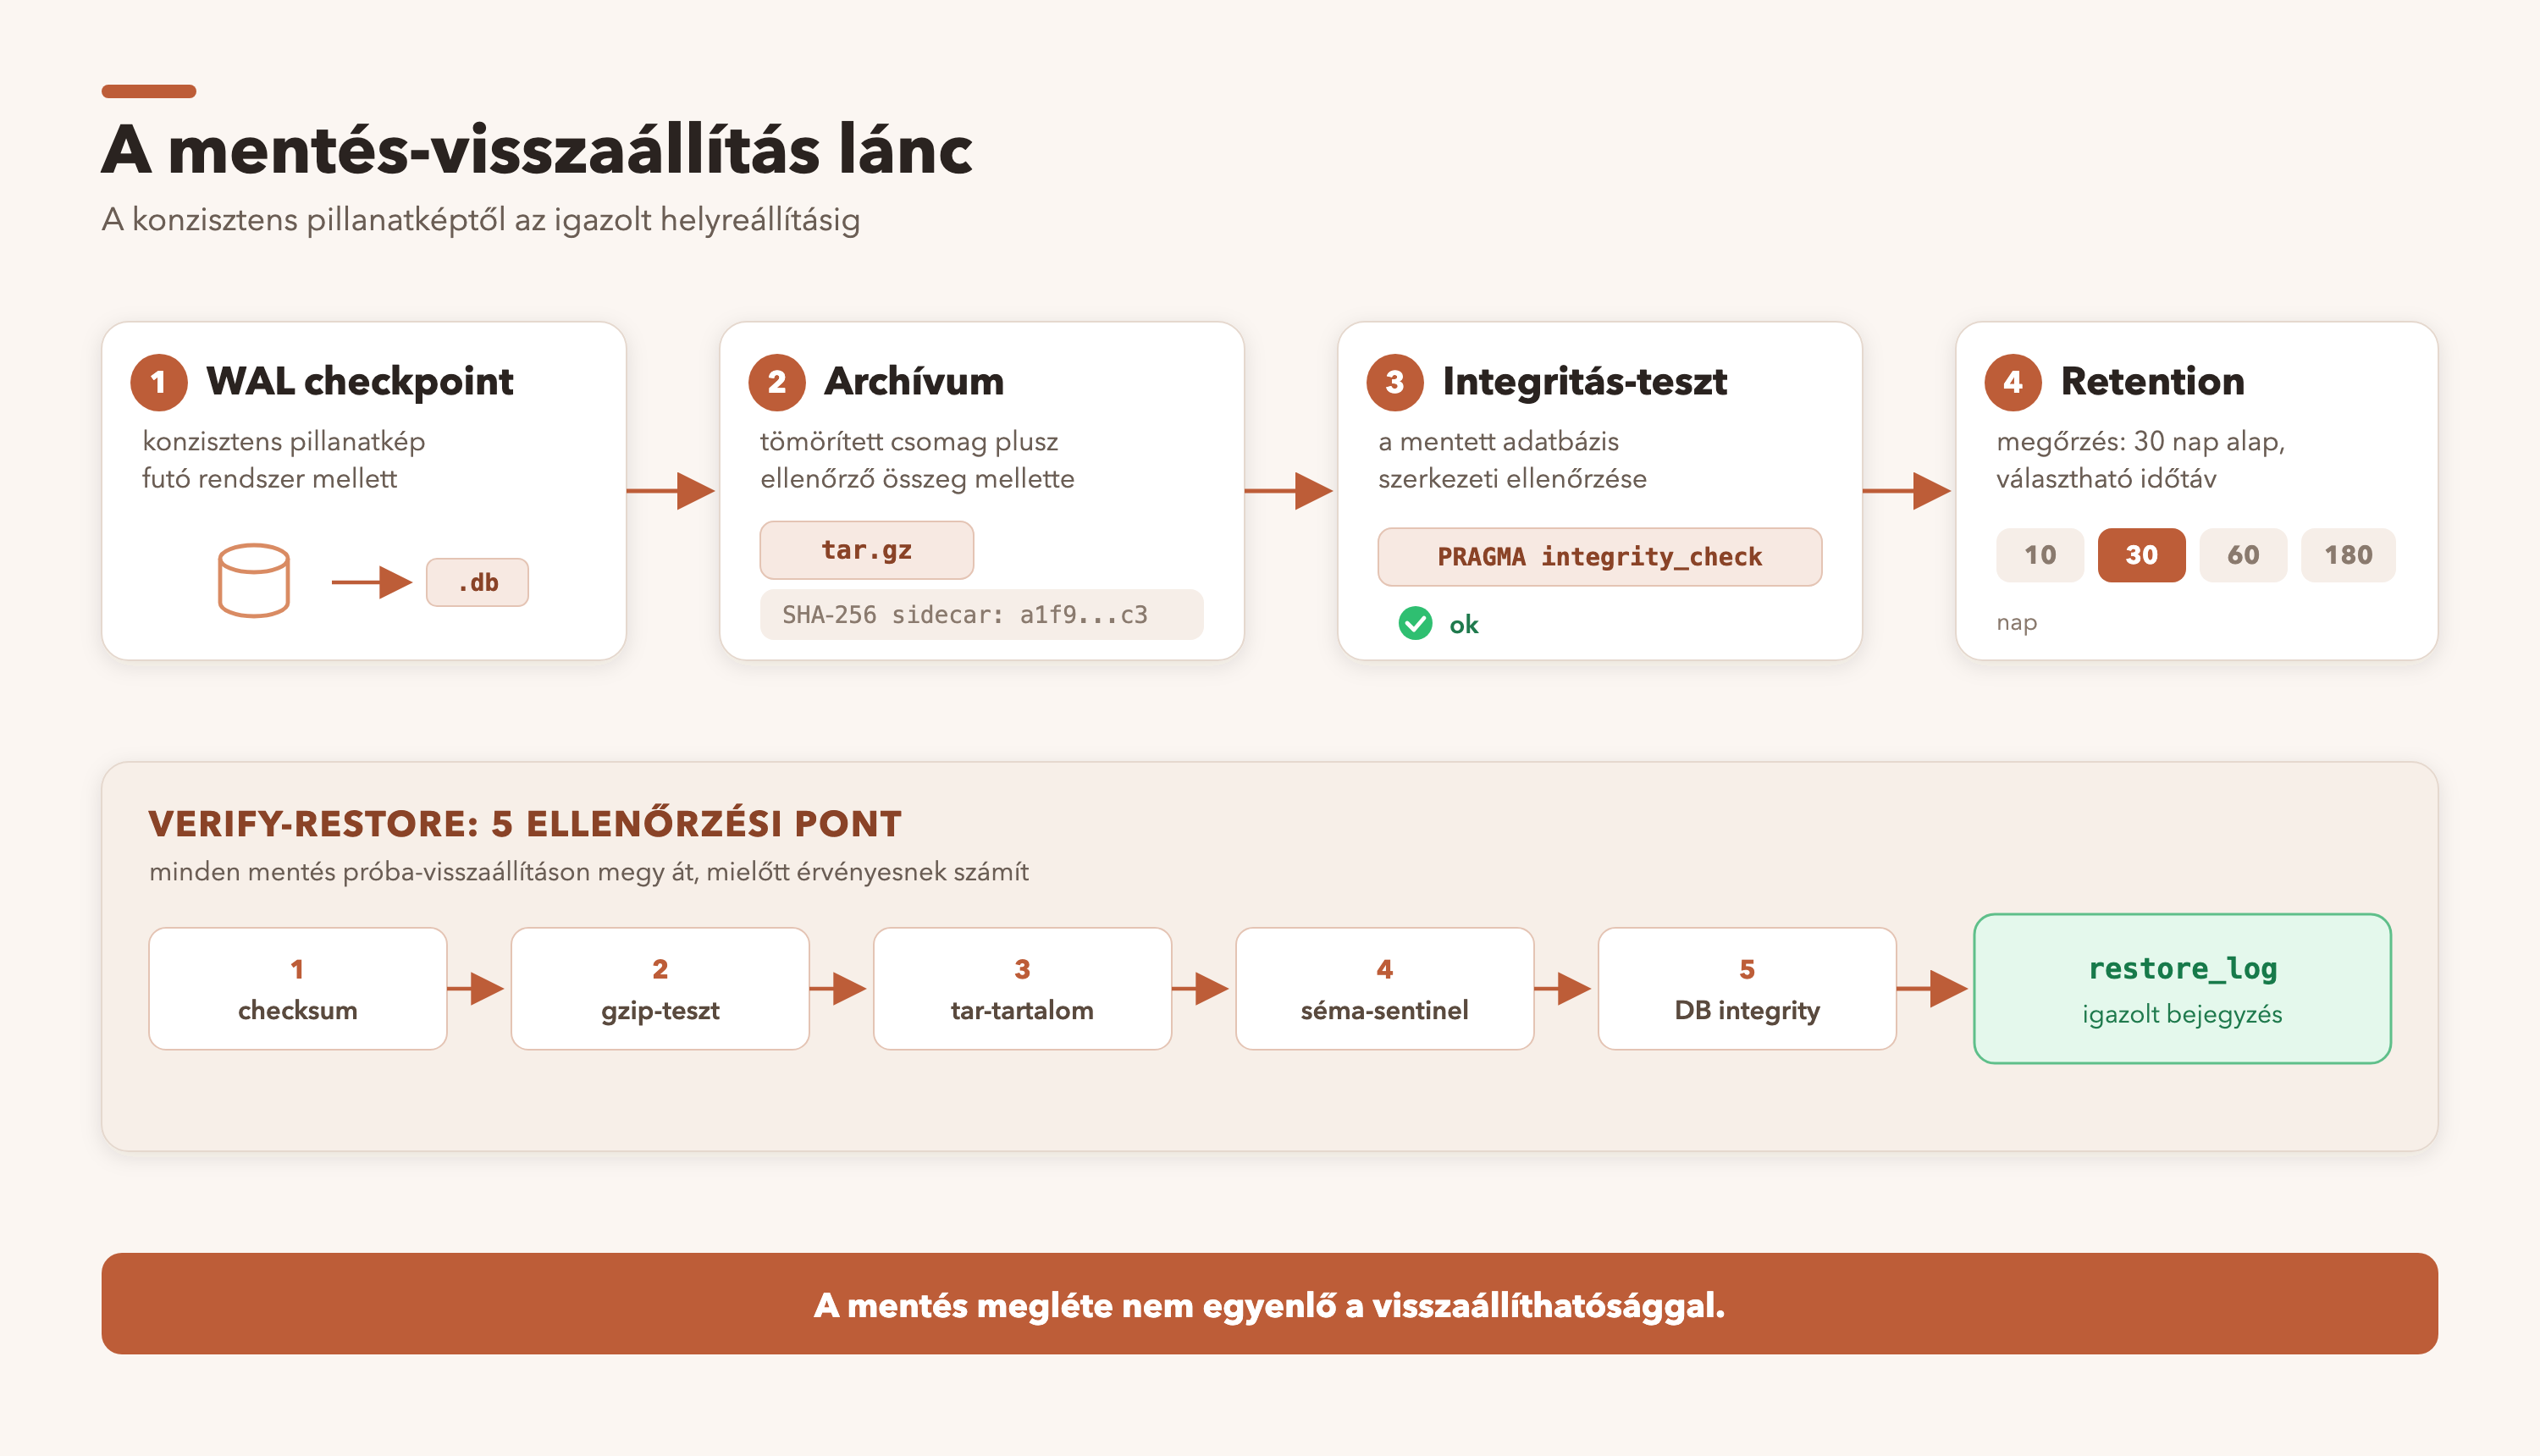
A helyes sorrend az, hogy a mentés előtt egy ellenőrzőpont a napló minden oldalát beírja a fő adatfájlba, és csak az így összezárt, önálló állapotról készül a tömörített archívum. A régi felállásban ez a két lépés nem volt összekötve, és egy újraindítási esemény éppen ezt a hibát tudta előhozni. Most a mentés első lépése maga az ellenőrzőpont, így az archívum egy magában is konzisztens pillanatkép.
2.2 Ellenőrzőösszeg és integritás-ellenőrzés
A "van mentés" és a "jó a mentés" között lényeges különbség van, és ezt két lépéssel hidaltam át. Minden archívum mellé egy SHA-256 ellenőrzőösszeg kerül külön kísérőfájlba. Ebből egy visszaállítás előtt igazolható, hogy az archívum nem sérült meg tárolás vagy másolás közben. A visszaállított adatbázison pedig lefut egy belső integritás-ellenőrzés, amely megerősíti, hogy nemcsak a fájl mérete stimmel, hanem a belső szerkezet is ép. Ez nem túlbiztosítás. Az az egyetlen mentés, amelyen soha nem fut integritás-ellenőrzés, egy látens kockázat, amiről csak az éles visszaállításnál derül ki, hogy használhatatlan.
3. Visszaállítás: a nem tesztelt mentés nem mentés
Az üzemeltetésben van egy tömör alapszabály: a nem tesztelt mentés egyenlő a nincs mentéssel. Amíg nem próbáltuk vissza, addig nem tudjuk, hogy visszaállítható. Ezért a mentés párja egy automatizált, emberi beavatkozás nélkül futtatható visszaállítás-ellenőrzés, amely öt ponton méri, hogy az archívumból valóban működő rendszer áll-e helyre: az ellenőrzőösszeg egyezése, a tömörítés épsége, az archívum szerkezete, egy séma-őrszem, és végül a helyreállított adatbázis integritása.
Két dolgot tettem még hozzá, mert egy visszaállítás nemcsak technikai, hanem elszámoltathatósági esemény is. Az egyik egy napló, amely rögzíti, ki, mikor, melyik archívumból és milyen eredménnyel állított vissza. Ez incidens utáni kivizsgáláshoz és megfelelőségi ellenőrzéshez egyaránt kell. A másik egy lépésenkénti visszaállítási forgatókönyv, amelyet a csapat bármely tagja végre tud hajtani, nem csak az eredeti fejlesztő. Ez a dokumentum incidenshelyzetben közvetlenül csökkenti a helyreállításig eltelő időt.
Két számot érdemes fejben tartani. A napi hajnali ütemezéssel a maximális adatvesztési ablak huszonnégy óra. A jelenlegi adatbázis-méret mellett a helyreállítás az ellenőrzéssel együtt néhány percen belül lefut. Ezek nem marketing-ígéretek, hanem az eljárásból következő, mérhető értékek. Egy katasztrófa-tűrési terv pontosan ezekre a számokra épül.
4. Audit trail: elszámoltathatóság adatvédelmi kockázat nélkül
4.1 Miért csak metaadat
Egy audit napló nélkül egy AI-ágens rendszer fekete doboz: nem mondható meg, melyik ágens módosított adatot, mikor és milyen műveletben. Éles üzemeltetésben ez elfogadhatatlan. A megoldásnál viszont van egy buktató, amit tudatosan kerültem ki. Ha az audit napló magát a tartalmat rögzíti, akkor egy második, párhuzamos adat-archívumot hozunk létre, tele ugyanazokkal az érzékeny adatokkal, csak most már két helyen kell védeni.
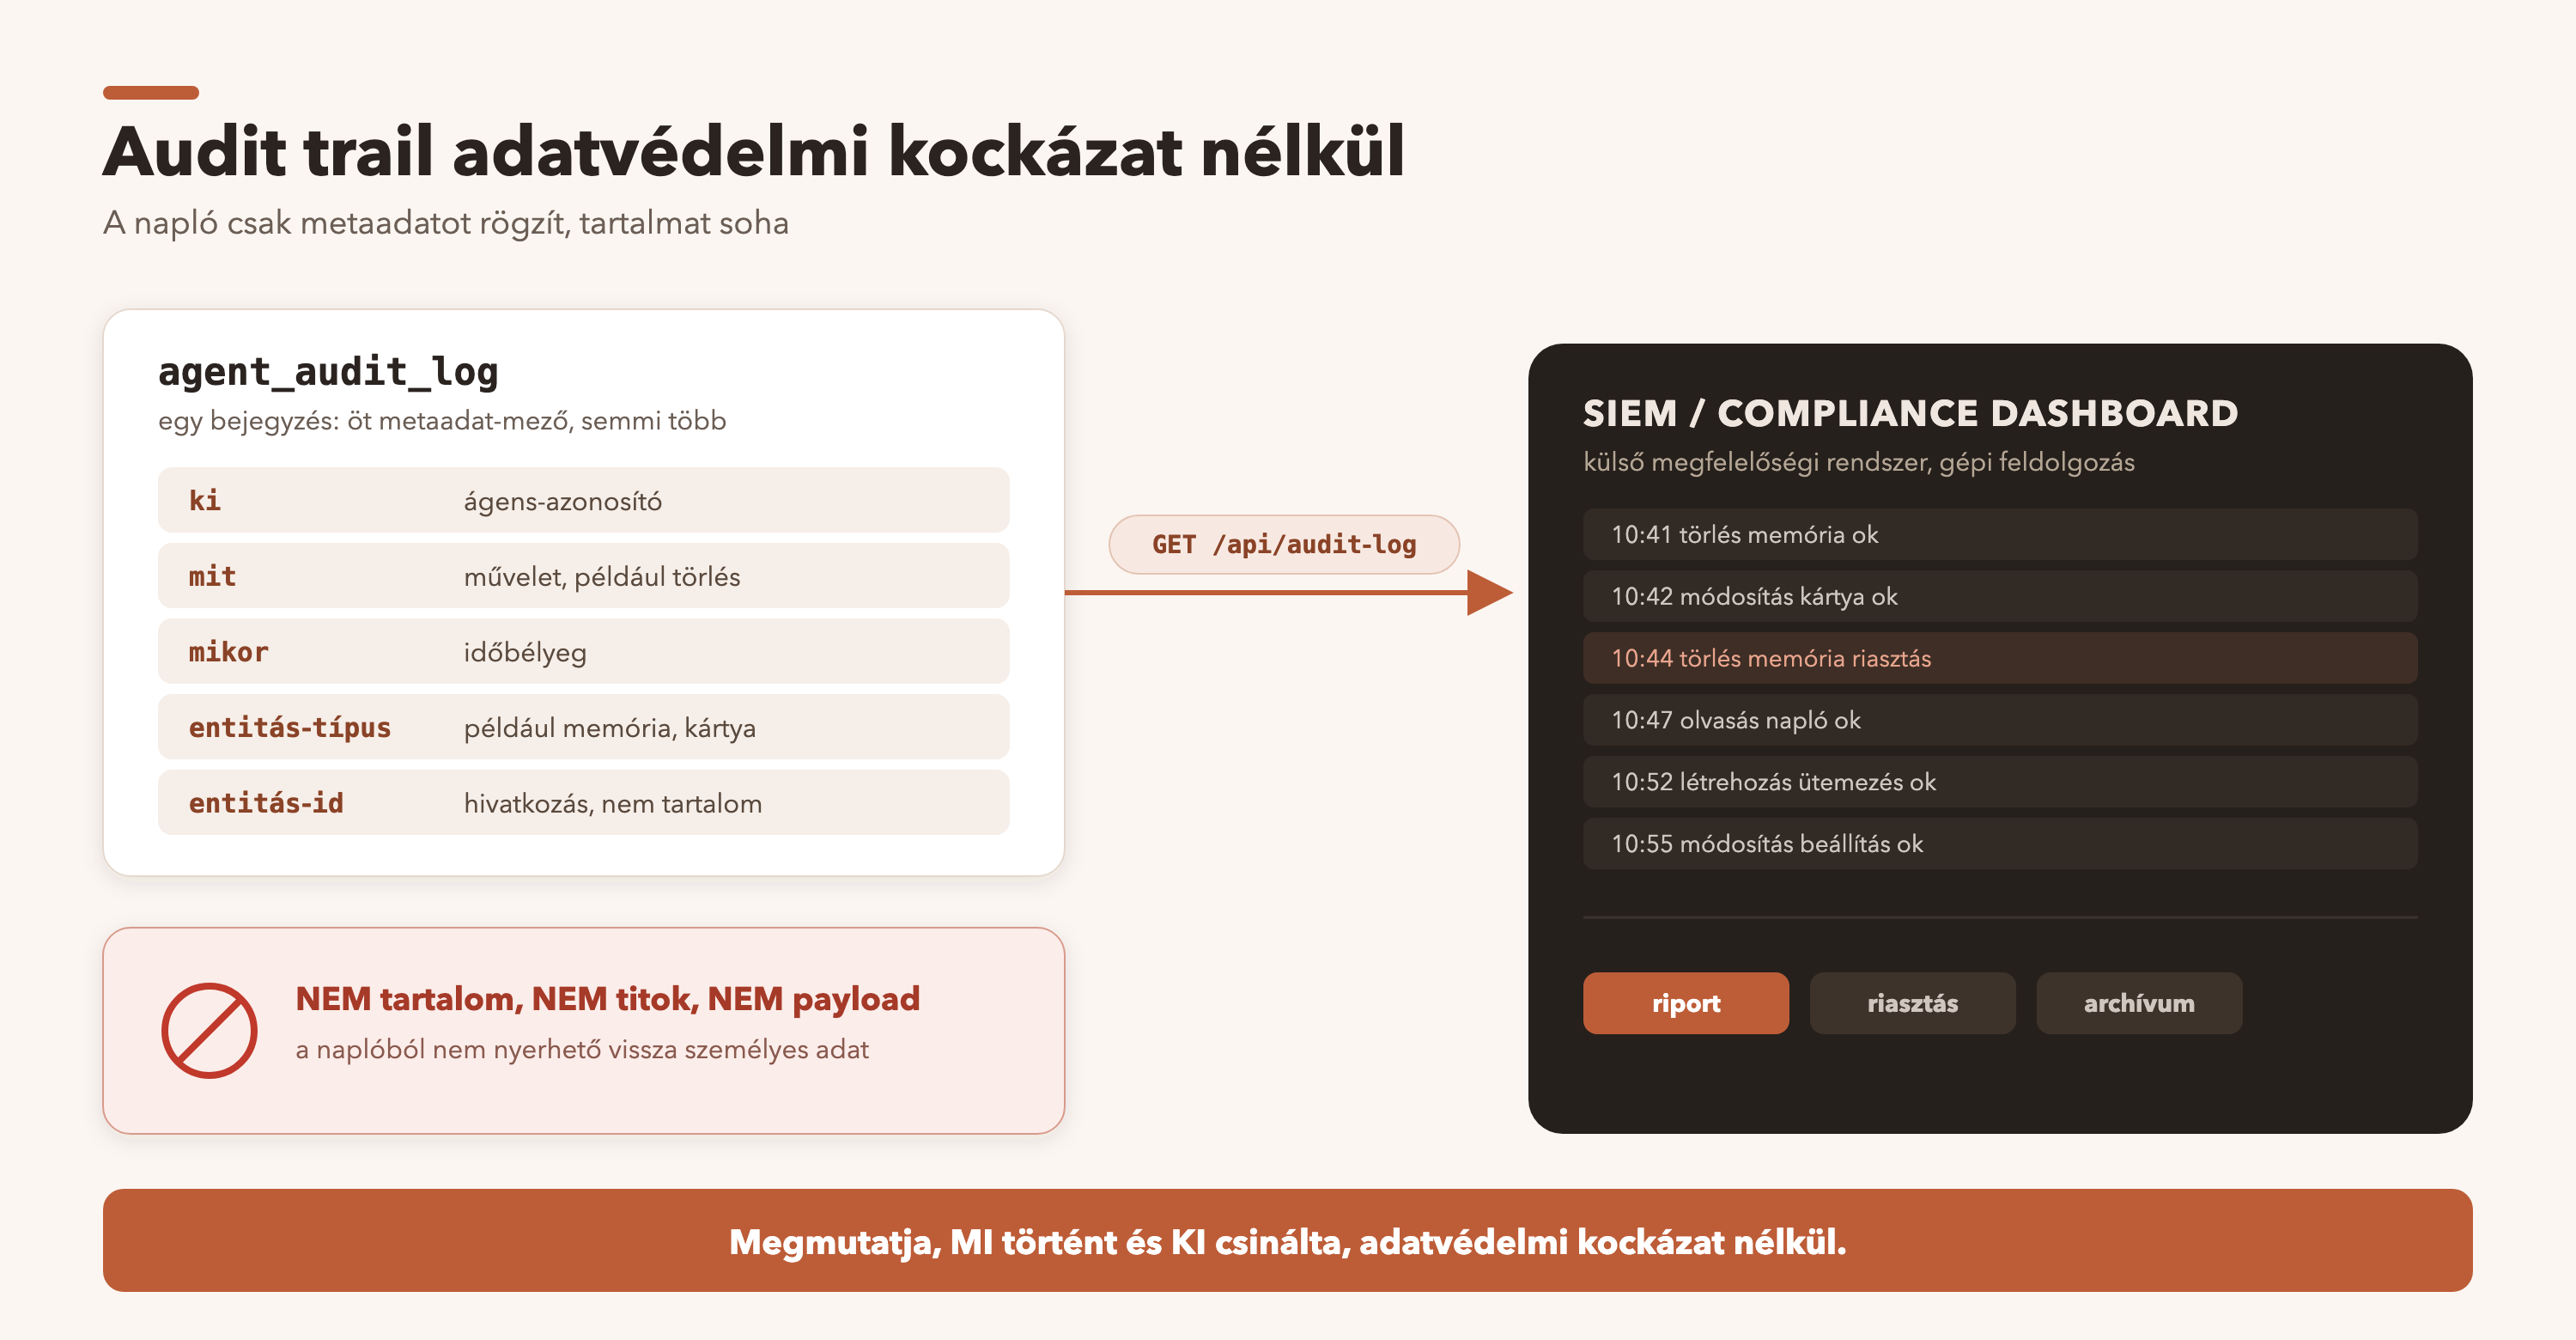
Ezért az ágens-audit napló kizárólag metaadatot tárol: ki végezte a műveletet, milyen esemény volt, milyen entitáson, mikor, és egy rövid összegzés. A memória tartalmát, az üzenetek szövegét, a feladatleírásokat nem menti. Így a napló megmutatja, mi történt és ki csinálta, de nem válik önmagában adatvédelmi kockázattá. Ez a különbség egy auditra felkészült és egy auditra felkészületlen rendszer között, és pontosan ez teszi az adatvédelmi elvekkel összeegyeztethetővé. A write-pontok a lényegi állapotváltozásoknál vannak: memória létrehozása, módosítása, törlése, feladatok kezelése, ágensek közötti üzenet, ágens létrehozása és törlése.
4.2 Kereshető API, ami beköthető a meglévő eszközbe
Az átláthatóság nem egy kézi log-túrásból fakad. A napló futásidőben, indexelt lekérdezéssel kereshető: forrás, közreműködő, eseménytípus és időintervallum szerint szűrhető. Ez a különbség egy "mi történt a rendszerben?" kérdésre adott pontos válasz és egy órákig tartó kézi keresés között.
A gyakorlati haszon viszont a beköthetőség. A napló egy egyszerű API-végponton keresztül elérhető, amit egy IT-csapat beköthet a saját biztonsági eseménykezelőjébe, log-aggregátorába vagy megfelelőségi felületébe anélkül, hogy a flotta belső szerkezetét értenie kellene. Ez a valódi enterprise-integrációs minta: ne kelljen hozzá egy újabb eszközt üzemeltetni, illeszkedjen ahhoz, ami már megvan.
5. Megőrzési házirend: az üzemeltető állítja, nem a kód
A megőrzés hossza konfigurálható, néhány rögzített opció közül (tíz, harminc, hatvan vagy száznyolcvan nap), alapértelmezésben harminc nap, és a limiten túli mentéseket a rendszer automatikusan törli. Ez szándékos döntés. Egy merev, mindenkire egységes érték vállalati kontextusban nem működik: az üzemeltető az adatvédelmi szabályzatához igazítja a megőrzést, nem fordítva.
A harminc napos alap az adatminimalizálás elvét követi: annyi adatot tartunk, amennyi a célhoz szükséges, nem többet. Ha egy jogszabályi kötelezettség hosszabb megőrzést ír elő, ott egy fontos elvi pontot érdemes tisztán tartani. Az elsődleges adatforrás mindig az élő adatbázis, a mentés ezt kiegészíti, nem helyettesíti. A mentés a helyreállításról szól, nem hosszú távú archívumról. Egy figyelmeztetés a gyakorlatból: az archívum önmagában érzékeny adatot tartalmaz, ezért a tárolása nem való automatikusan szinkronizált felhő-mappába, hanem tudatosan kezelt helyre.
6. Modularizáció és séma-verziózás: az üzemeltetési életciklus
Ez a réteg nem a semmiből nőtt ki. Előfeltétele volt egy korábbi, kevésbé látványos munka: a monolitikus kódalap szétbontása és egy verziózott séma-kezelés bevezetése. Az eredeti rendszer a teljes funkcionalitást lényegében egyetlen, sok ezer soros fájlban tartotta, a séma pedig ad hoc módon fejlődött. Egy ilyen felállásban egy incidens visszakövetése nagyon nehéz, mert nincs szétválasztva a logika, a séma-verziózás és az audit-réteg.
A szétbontott, önálló útvonalkezelőkre osztott kód azt jelenti, hogy egy hiba izolálható és javítható a többi rész megbolygatása nélkül, egy hibás módosítás hatóköre pedig szűkebb. A verziózott séma-kezelés mellett minden szerkezeti módosítás azonosítható: egy éles incidensben a "benne van-e már ez a séma-módosítás?" kérdésre egy lekérdezés a válasz, nem egy kézi fájl-összehasonlítás. Ez adja a séma-változásoknak azt az explicit életciklust, amelyre az IT-csapat saját eszközei rá tudnak illeszkedni. Az elszámoltathatóság, amely szerint minden változásnak van felelőse és minden incidens visszakövethető, a klasszikus változáskezelés alapelve. Ez a réteg ugyanezt az elvet valósítja meg AI-ágens környezetben, ahol korábban eszköz sem volt rá.
7. A három kérdés, amire ez a réteg igent mond
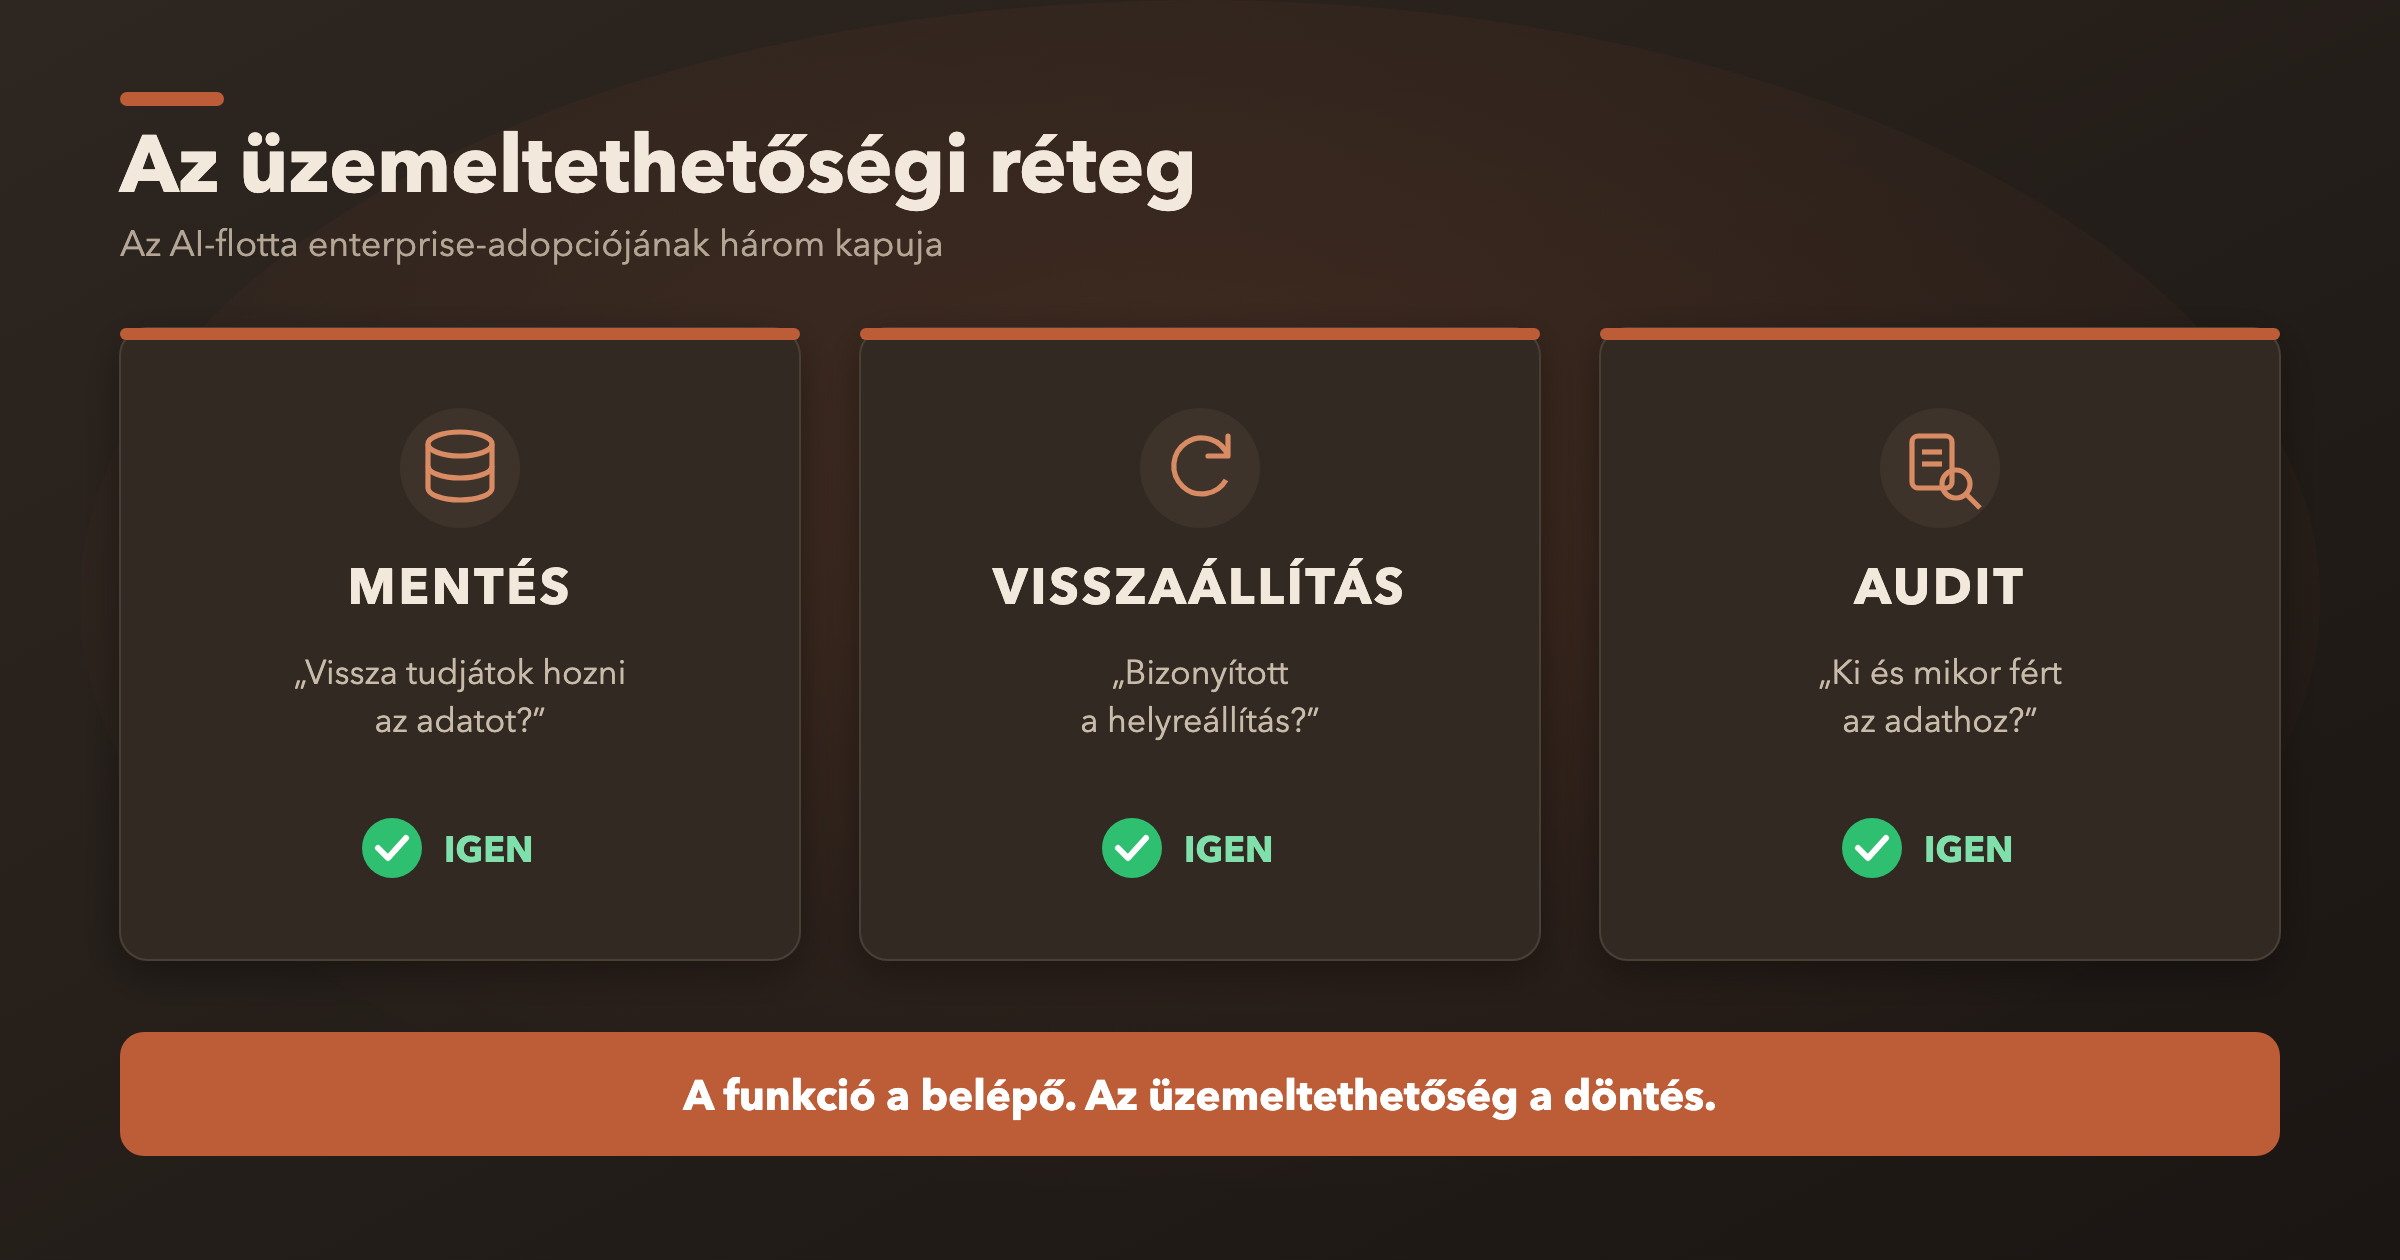
Ha egy vállalati partner az AI-flottát mérlegeli, jellemzően három kérdést tesz fel, és mindhárom az üzemeltethetőségről szól, nem a képességről:
- Ha törlik a termelési adatot, vissza tudjátok hozni? A mentés WAL-biztos pillanatképpel, ellenőrzőösszeggel és integritás-ellenőrzéssel erre igent mond.
- Le van dokumentálva a vészhelyzeti visszaállítás eljárása, és bizonyított? Az ötpontos, automatizált visszaállítás-ellenőrzés, a visszaállítási napló és a lépésenkénti forgatókönyv erre igent mond.
- Tudjátok auditálni, ki és mikor fért az adataimhoz? A metaadat-alapú, kereshető és beköthető audit napló erre igent mond, adatvédelmi kockázat nélkül.
A korábbi felállás ezekre az alapkérdésekre nem tudott válaszolni. Nem azért, mert a képességek hiányoztak, hanem mert az a réteg hiányzott, amely a képességet üzemeltethetővé teszi. Az én olvasatomban ez a réteg nem egy differenciáló extra, hanem a belépési minimum. Amíg nincs meg, addig az AI-flotta egy okos, de kiszámíthatatlan fekete doboz marad, és az IT-osztálynak éppen ezzel a kiszámíthatatlansággal kellene szembenéznie.
8. Összefoglalás
| Üzemeltetői kérdés | A réteg nélkül | Az üzemeltethetőségi réteggel |
|---|---|---|
| Mentés futó adatbázis mellett | Inkonzisztens másolat kockázata | WAL-biztos, konzisztens pillanatkép |
| A mentés épsége | Nincs ellenőrzés, látens kockázat | SHA-256 és integritás-ellenőrzés |
| Visszaállíthatóság | Feltételezés, nem bizonyíték | Ötpontos, naplózott ellenőrzés |
| Incidens-helyreállítás | Csak a fejlesztő tudja, ad hoc | Dokumentált forgatókönyv, mérhető idő |
| Ki mit módosított | Fekete doboz, nem visszakövethető | Metaadat-alapú audit napló |
| Megfelelőségi integráció | Nincs beköthető felület | Kereshető API, eseménykezelőbe köthető |
| Megőrzés | Nincs szabályozva | Konfigurálható, adatminimalizáló alap |
| Séma-változások követése | Ad hoc, kézi összevetés | Verziózott, lekérdezhető |
A fejlesztés önmagában nem látványos. Egy mentő szkript, egy visszaállítás-ellenőrző, egy audit napló, egy dashboard-felület hozzá. A jelentősége viszont nem a kód mennyiségében van. Ez az a réteg, amelyen egy komoly bevezetés elindul vagy elakad. Nem azt ígéri, hogy az AI okosabb lesz. Azt ígéri, hogy az AI-flotta üzemeltetési szempontból kiszámítható, visszakövethető és visszaállítható. A tapasztalatom szerint egy vállalati döntéshozónak ez fontosabb, mint bármelyik önmagában vett képesség.
A cikk a cett/marveen fork adat- és üzembiztonsági rétegének 2026-08-22-i állapotát tükrözi.
Van kérdésed, vagy beszélgetnél a témáról? Írj emailben: info@jonasgergo.hu, vagy keress meg LinkedInen.
English version
It is not its capabilities that make an AI fleet adoptable in an enterprise environment. Capability is the entry ticket. The decision is made by operability: whether an organisation knows what happens in the system, what has changed, and what happens if something breaks. On my own fleet I have now built in exactly this layer: verified backup, tested restore and a metadata-based audit log. Few new features, all the more peace of mind. In this article I write about this development, and about why this is the layer on which a serious B2B negotiation starts or stalls.
1. The feature is the entry ticket, operability is the decision
When an organisation weighs an AI system, the demo typically talks about capabilities: what it can do, how fast it is, how much work it takes off the team. This is important, but in my experience adoption is not decided here. The decision-maker, especially on the IT side, does not get stuck on a feature. Two questions stop them. The first: if something breaks, what is the protocol? The second: what do I show the audit? If the system does not give a concrete, documented answer to these, the negotiation, in a technical sense, does not even begin.
In my reading this is not pessimism but the actual logic of operations. An organisation lets a new tool near live data only if it can keep its risks in hand. That is why on my fleet I did not start with the next spectacular capability but with the layer beneath it: backup, restore and audit. These cannot be sold in a demo, but without exactly these there will be no live rollout.
2. Backup: existing and good are not the same thing
2.1 A WAL-safe snapshot
The state of the fleet lives in an SQLite database that runs in write-ahead logging (WAL) mode. This is an advantage for performance, but a trap for backup. If someone simply copies the files at that point, they easily get an inconsistent copy: the main data file, the shared-memory file and the write-ahead log together make up a consistent state, and a non-atomic copy of them can produce a broken database. The backup still gets created, only the restore fails on it, typically at the worst moment.
The correct order is that before the backup a checkpoint writes every page of the log into the main data file, and the compressed archive is made only from that closed, self-contained state. In the old setup these two steps were not linked, and a restart event could trigger exactly this fault. Now the first step of the backup is the checkpoint itself, so the archive is a snapshot that is consistent on its own.
2.2 Checksum and integrity check
Between "there is a backup" and "the backup is good" there is an essential difference, and I bridged it with two steps. Every archive comes with a SHA-256 checksum stored in a separate companion file. From this, before a restore, it can be verified that the archive was not damaged in storage or copying. On the restored database a built-in integrity check runs, which confirms that not only the file size is right but the internal structure is intact too. This is not overkill. The one backup that is never integrity-checked is a latent risk: you find out it is unusable only at a real restore.
3. Restore: an untested backup is not a backup
In operations there is a short basic rule: an untested backup equals no backup. Until we have tried restoring it, we do not know that it can be restored. That is why the counterpart of the backup is an automated restore check that can run without human intervention and measures at five points whether a working system really comes back from the archive: the checksum matches, the compression is intact, the archive structure is right, a schema check passes, and finally the recovered database passes its integrity check.
I added two more things, because a restore is not only a technical but also an accountability event. One is a log that records who restored, when, from which archive and with what result. This is needed both for post-incident investigation and for compliance checks. The other is a step-by-step restore playbook that any member of the team can carry out, not just the original developer. In an incident this document directly reduces the time to recovery.
Two numbers are worth keeping in mind. With the daily early-morning schedule, the maximum data-loss window is twenty-four hours. With the current database size, the recovery together with the verification runs within a few minutes. These are not marketing promises but measurable values that follow from the procedure. A disaster-recovery plan is built on exactly these numbers.
4. Audit trail: accountability without a data-protection risk
4.1 Why only metadata
Without an audit log, an AI agent system is a black box: it cannot be said which agent changed data, when and in what operation. In live operation this is unacceptable. In the solution, however, there is a pitfall that I consciously avoided. If the audit log records the content itself, we create a second, parallel data archive full of the same sensitive data, only now it has to be protected in two places.
That is why the agent audit log stores metadata only: who performed the operation, what the event was, on what entity, when, and a short summary. It does not save the content of the memory, the text of messages, or task descriptions. This way the log shows what happened and who did it, but does not in itself become a data-protection risk. This is the difference between a system prepared for an audit and one unprepared for it, and this is exactly what makes it compatible with data-protection principles. Entries are written at the essential state changes: creating, modifying and deleting memory, task handling, messages between agents, creating and deleting agents.
4.2 A searchable API that can be plugged into existing tools
Transparency does not come from digging through logs by hand. The log can be searched at runtime with an indexed query: it can be filtered by source, actor, event type and time interval. This is the difference between an exact answer to the question "what happened in the system?" and hours of manual searching.
The practical benefit, however, is pluggability. The log is reachable through a simple API endpoint, which an IT team can plug into its own security event management system (SIEM), log aggregator or compliance interface without having to understand the internal structure of the fleet. This is the real enterprise integration pattern: you should not have to operate yet another tool for it, it should fit what already exists.
5. Retention policy: the operator sets it, not the code
The retention period can be chosen from a few fixed options (ten, thirty, sixty or one hundred and eighty days), thirty days by default, and the system automatically deletes backups beyond the limit. This is a deliberate decision. A rigid value uniform for everyone does not work in an enterprise context: the operator adjusts retention to their data-protection policy, not the other way round.
The thirty-day default follows the principle of data minimisation: we keep as much data as the purpose requires, no more. If a legal obligation prescribes longer retention, there is an important point of principle worth keeping clear. The primary data source is always the live database, the backup complements it, it does not replace it. The backup is about recovery, not long-term archiving. A warning from practice: the archive in itself contains sensitive data, so its storage does not belong in an automatically synchronised cloud folder but in a consciously managed place.
6. Modularisation and schema versioning: the operational lifecycle
This layer did not grow out of nothing. Its precondition was an earlier, less spectacular piece of work: breaking up the monolithic codebase and introducing versioned schema management. The original system kept essentially the whole functionality in a single file of many thousands of lines, and the schema evolved ad hoc. In such a setup tracing back an incident is very hard, because the logic, the schema versioning and the audit layer are not separated.
Code split into independent route handlers means that a fault can be isolated and fixed without disturbing the other parts, and the scope of a faulty change is narrower. With versioned schema management, every structural change can be identified: in a live incident the question "is this schema change already in?" is answered by a query, not by a manual file comparison. This gives schema changes the explicit lifecycle that the IT team's own tools can attach to. Accountability, meaning that every change has an owner and every incident can be traced back, is a basic principle of classic change management. This layer implements the same principle in an AI agent environment, where there had previously been no tool for it.
7. The three questions this layer answers yes to
When an enterprise partner weighs an AI fleet, they typically ask three questions, and all three are about operability, not capability:
- If the production data is deleted, can you bring it back? The backup, with a WAL-safe snapshot, a checksum and an integrity check, answers yes.
- Is the emergency restore procedure documented, and proven? The five-point restore check, the restore log and the step-by-step playbook answer yes.
- Can you audit who accessed my data, and when? The metadata-based, searchable and pluggable audit log answers yes, without a data-protection risk.
The earlier setup could not answer these basic questions. Not because capabilities were missing, but because the layer was missing that makes a capability operable. In my reading this layer is not a differentiating extra but the minimum entry requirement. Until it is there, the AI fleet remains a clever but unpredictable black box, and it is exactly this unpredictability that the IT department would have to face.
8. Summary
| Operator question | Without the layer | With the operability layer |
|---|---|---|
| Backup next to a running database | Risk of an inconsistent copy | A WAL-safe, consistent snapshot |
| Integrity of the backup | No check, a latent risk | SHA-256 and an integrity check |
| Restorability | An assumption, not proof | A five-point, logged check |
| Incident recovery | Only the developer knows, ad hoc | A documented playbook, measurable time |
| Who changed what | A black box, not traceable | A metadata-based audit log |
| Compliance integration | No pluggable interface | A searchable API, pluggable into an event manager |
| Retention | Not regulated | Configurable, a data-minimising default |
| Tracking schema changes | Ad hoc, manual comparison | Versioned, queryable |
The development is not spectacular in itself. A backup script, a restore checker, an audit log and a dashboard interface to go with them. Its significance, however, is not in the amount of code. This is the layer on which a serious rollout starts or stalls. It does not promise that the AI will get cleverer. It promises that the AI fleet is operationally predictable, traceable and restorable. In my experience, for an enterprise decision-maker this matters more than any single capability taken alone.
This article reflects the state of the data and operational-safety layer of the cett/marveen fork on 22 August 2026.
Do you have a question, or would you like to talk about the topic? Write to me by email: info@jonasgergo.hu, or find me on LinkedIn.