Hordozható skillek
amikor egy workflow túl sok nevet ismer
when a workflow knows too many names
An English version of this article follows below. Jump to the English version.
Egy automatizált munkafolyamat annál hordozhatóbb, minél kevesebb nevet ismer. Ez a mondat végigkísérte azt a fejlesztést, amelyről itt írok: kivezettük a beégetett ügynök-neveket a saját AI-flottám skill-készletéből, és képesség-alapú, futásidőben feloldódó helyettesítőkre cseréltük őket. A végeredmény technikailag apró, a következménye viszont nem: a skillek mostantól túlélik az ügynök-átnevezést, a cserét, és akár egy másik flottába is átemelhetők.
1. A probléma: a beégetett név mint törékenység
A flottám ügynökei megosztott skill-készletből dolgoznak: ezek újrafelhasználható eljárásleírások, amelyek megmondják, hogyan kell egy visszatérő feladatot elvégezni. Sok ilyen skill konkrét ügynök-neveket tartalmazott. Ott állt bennük, hogy "ezt a lépést Jarvis végzi", vagy "a backend-részt add át Zacknek". Amíg semmi sem változik, ez tökéletesen működik.
A gond akkor kezdődik, amikor változik valami. Egy ügynök átnevezése, egy szerepkör átadása, egy flotta-átszervezés, és hirtelen minden olyan skill javításra szorul, amelybe beégettük az illető nevét. Az én esetemben 51 fájlban 168 ilyen hely volt. Ez 168 lehetséges törési pont egyetlen névcserénél. Ez a klasszikus IT-ből jól ismert antipattern: konfiguráció a kódban. Ha egy szkript konkrét szervernevet, IP-címet vagy felhasználót tartalmaz, akkor az a szkript minden környezeti változásnál kézi beavatkozást kér. A skill-készlet ugyanilyen adósságot halmozott fel, csak ügynök-nevekben.
Az én olvasatomban a hardkódolt név nem stílushiba, hanem üzemeltetési kockázat. Egy dokumentáció, amely egy ma futó ügynök nevére hivatkozik, holnap, az ügynök átnevezése után, félrevezető lesz. A skill mint tudásbázis csak addig ér valamit, amíg a benne leírt szándék a névtől függetlenül is érvényes marad.
2. Az analógia: interfész és implementáció
A megoldás nem új gondolat, csak egy jól ismert programozási elv áthelyezése egy másik rétegbe. Egy jól megírt függvény nem azt tudja, pontosan melyik adatbázist hívja. Azt tudja, hogy szüksége van egy adatbázisra, amely egy adott képességgel rendelkezik. Az interfész és a mögötte álló konkrét megvalósítás szét van választva. Ugyanez a minta a környezetfüggetlen üzemeltetésben is megjelenik: a deployment pipeline nem tartalmaz környezet-specifikus értéket, hanem service registry vagy környezeti változó oldja fel futáskor. A tizenkét faktoros alkalmazás módszertana ezt a "konfiguráció a kódtól elválasztva" elvként fogalmazza meg.
A skilljeim korábban a rossz oldalon álltak: konkrét nevet hívtak. A cél az volt, hogy átkerüljenek a jó oldalra: a "mit kell csinálni" (a skill logikája) elváljon a "ki csinálja" résztől (a flotta aktuális összetétele). A szoftverfejlesztésben ezt a szétválasztást függőség-injektálásnak hívják. Nálam a "függőség" egy ügynök-szerep.
3. Képesség-alapú helyettesítők
3.1 Miért képesség, és nem név?
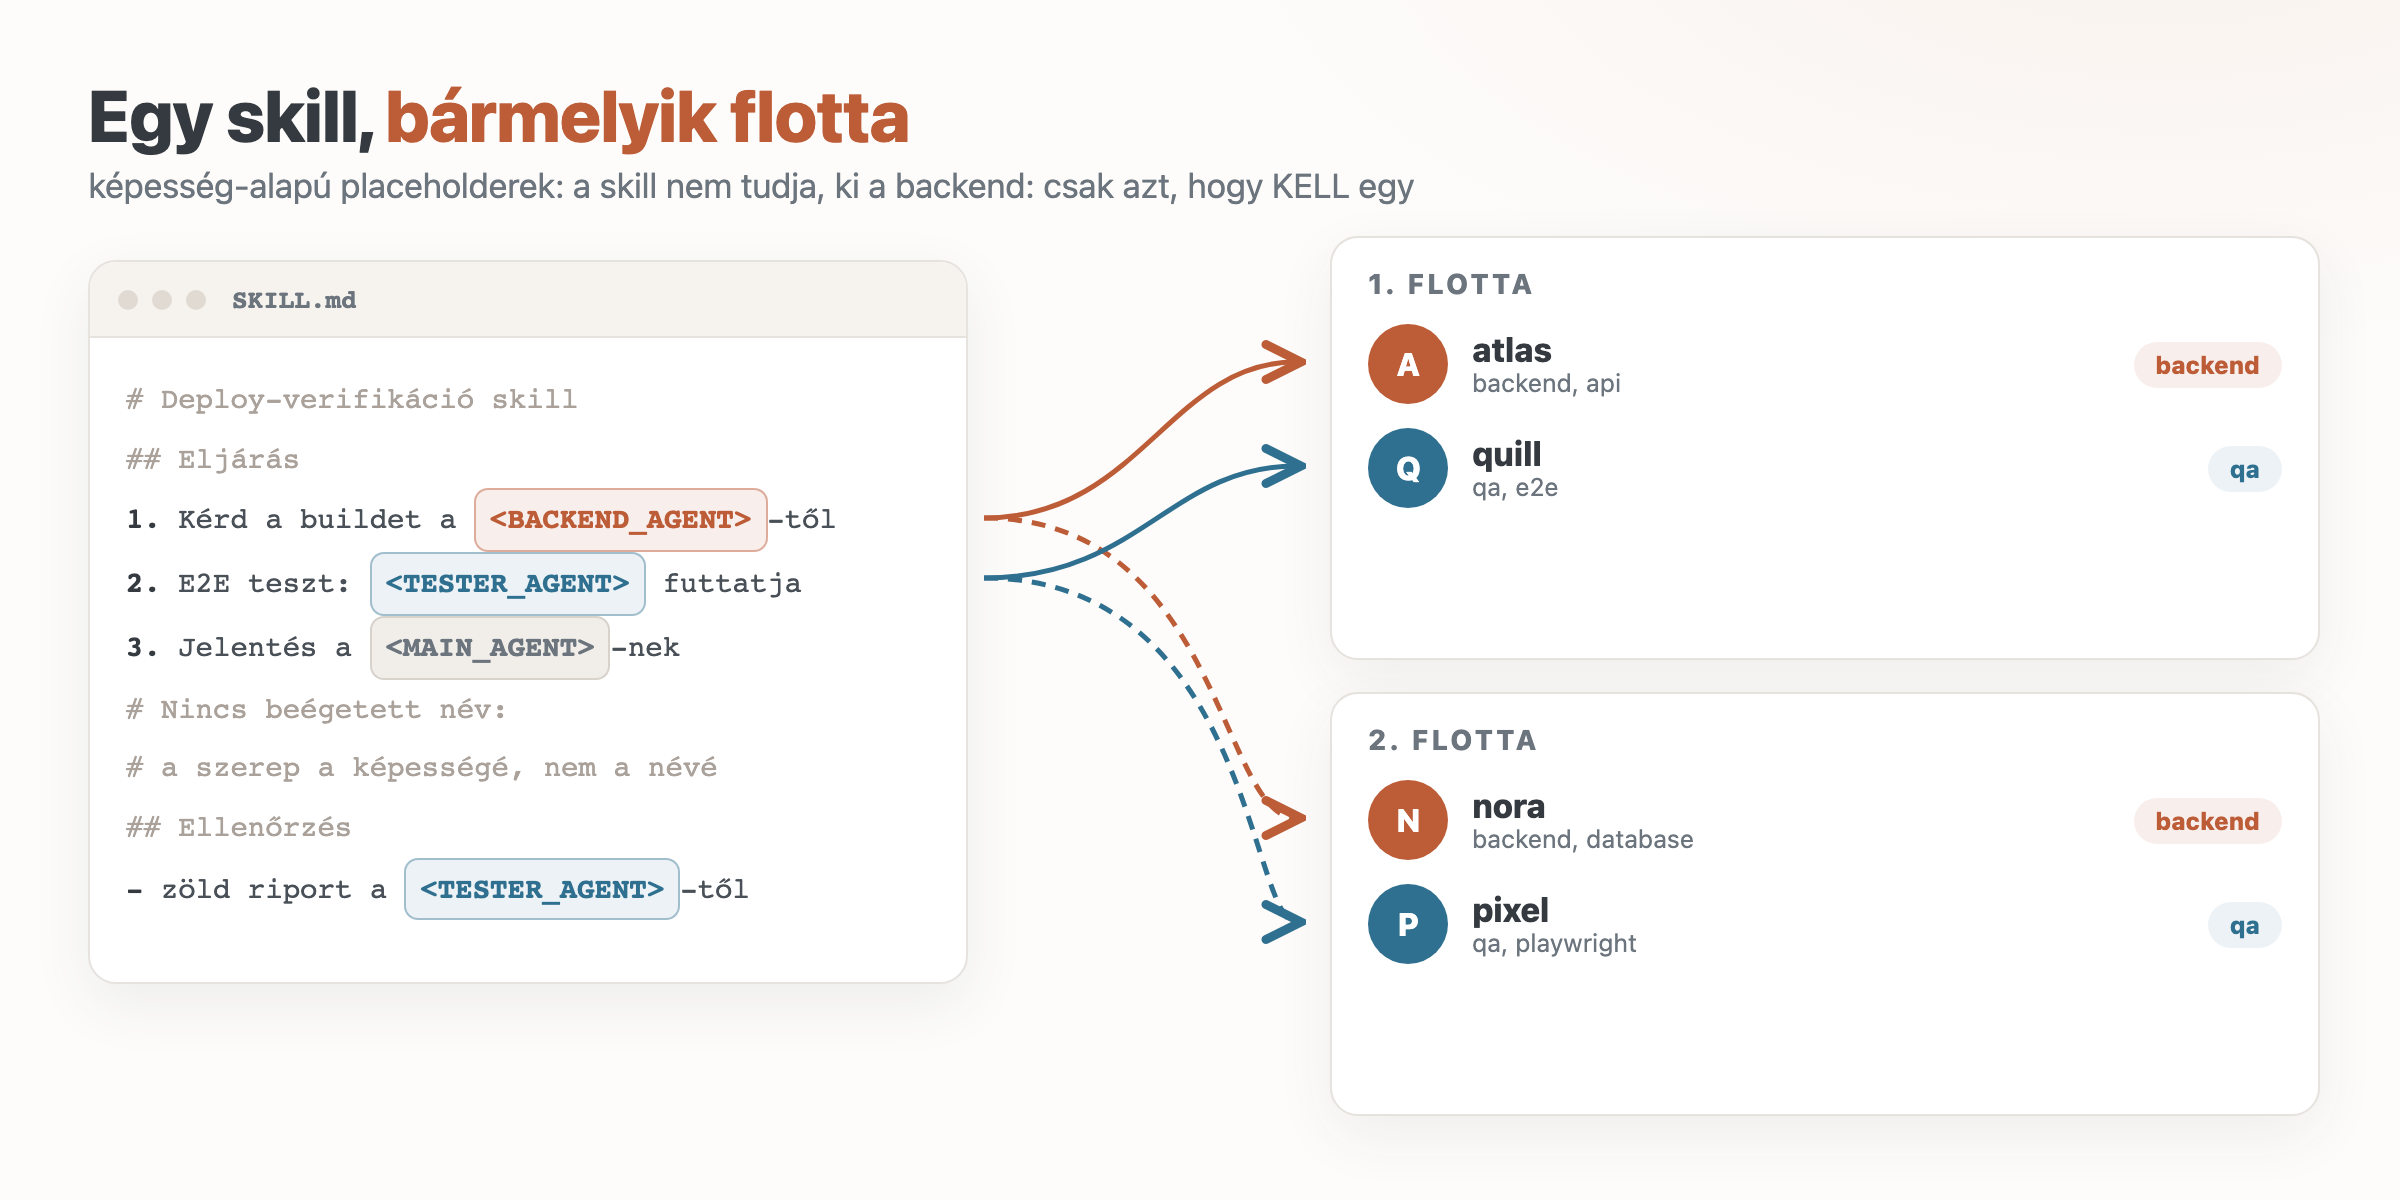
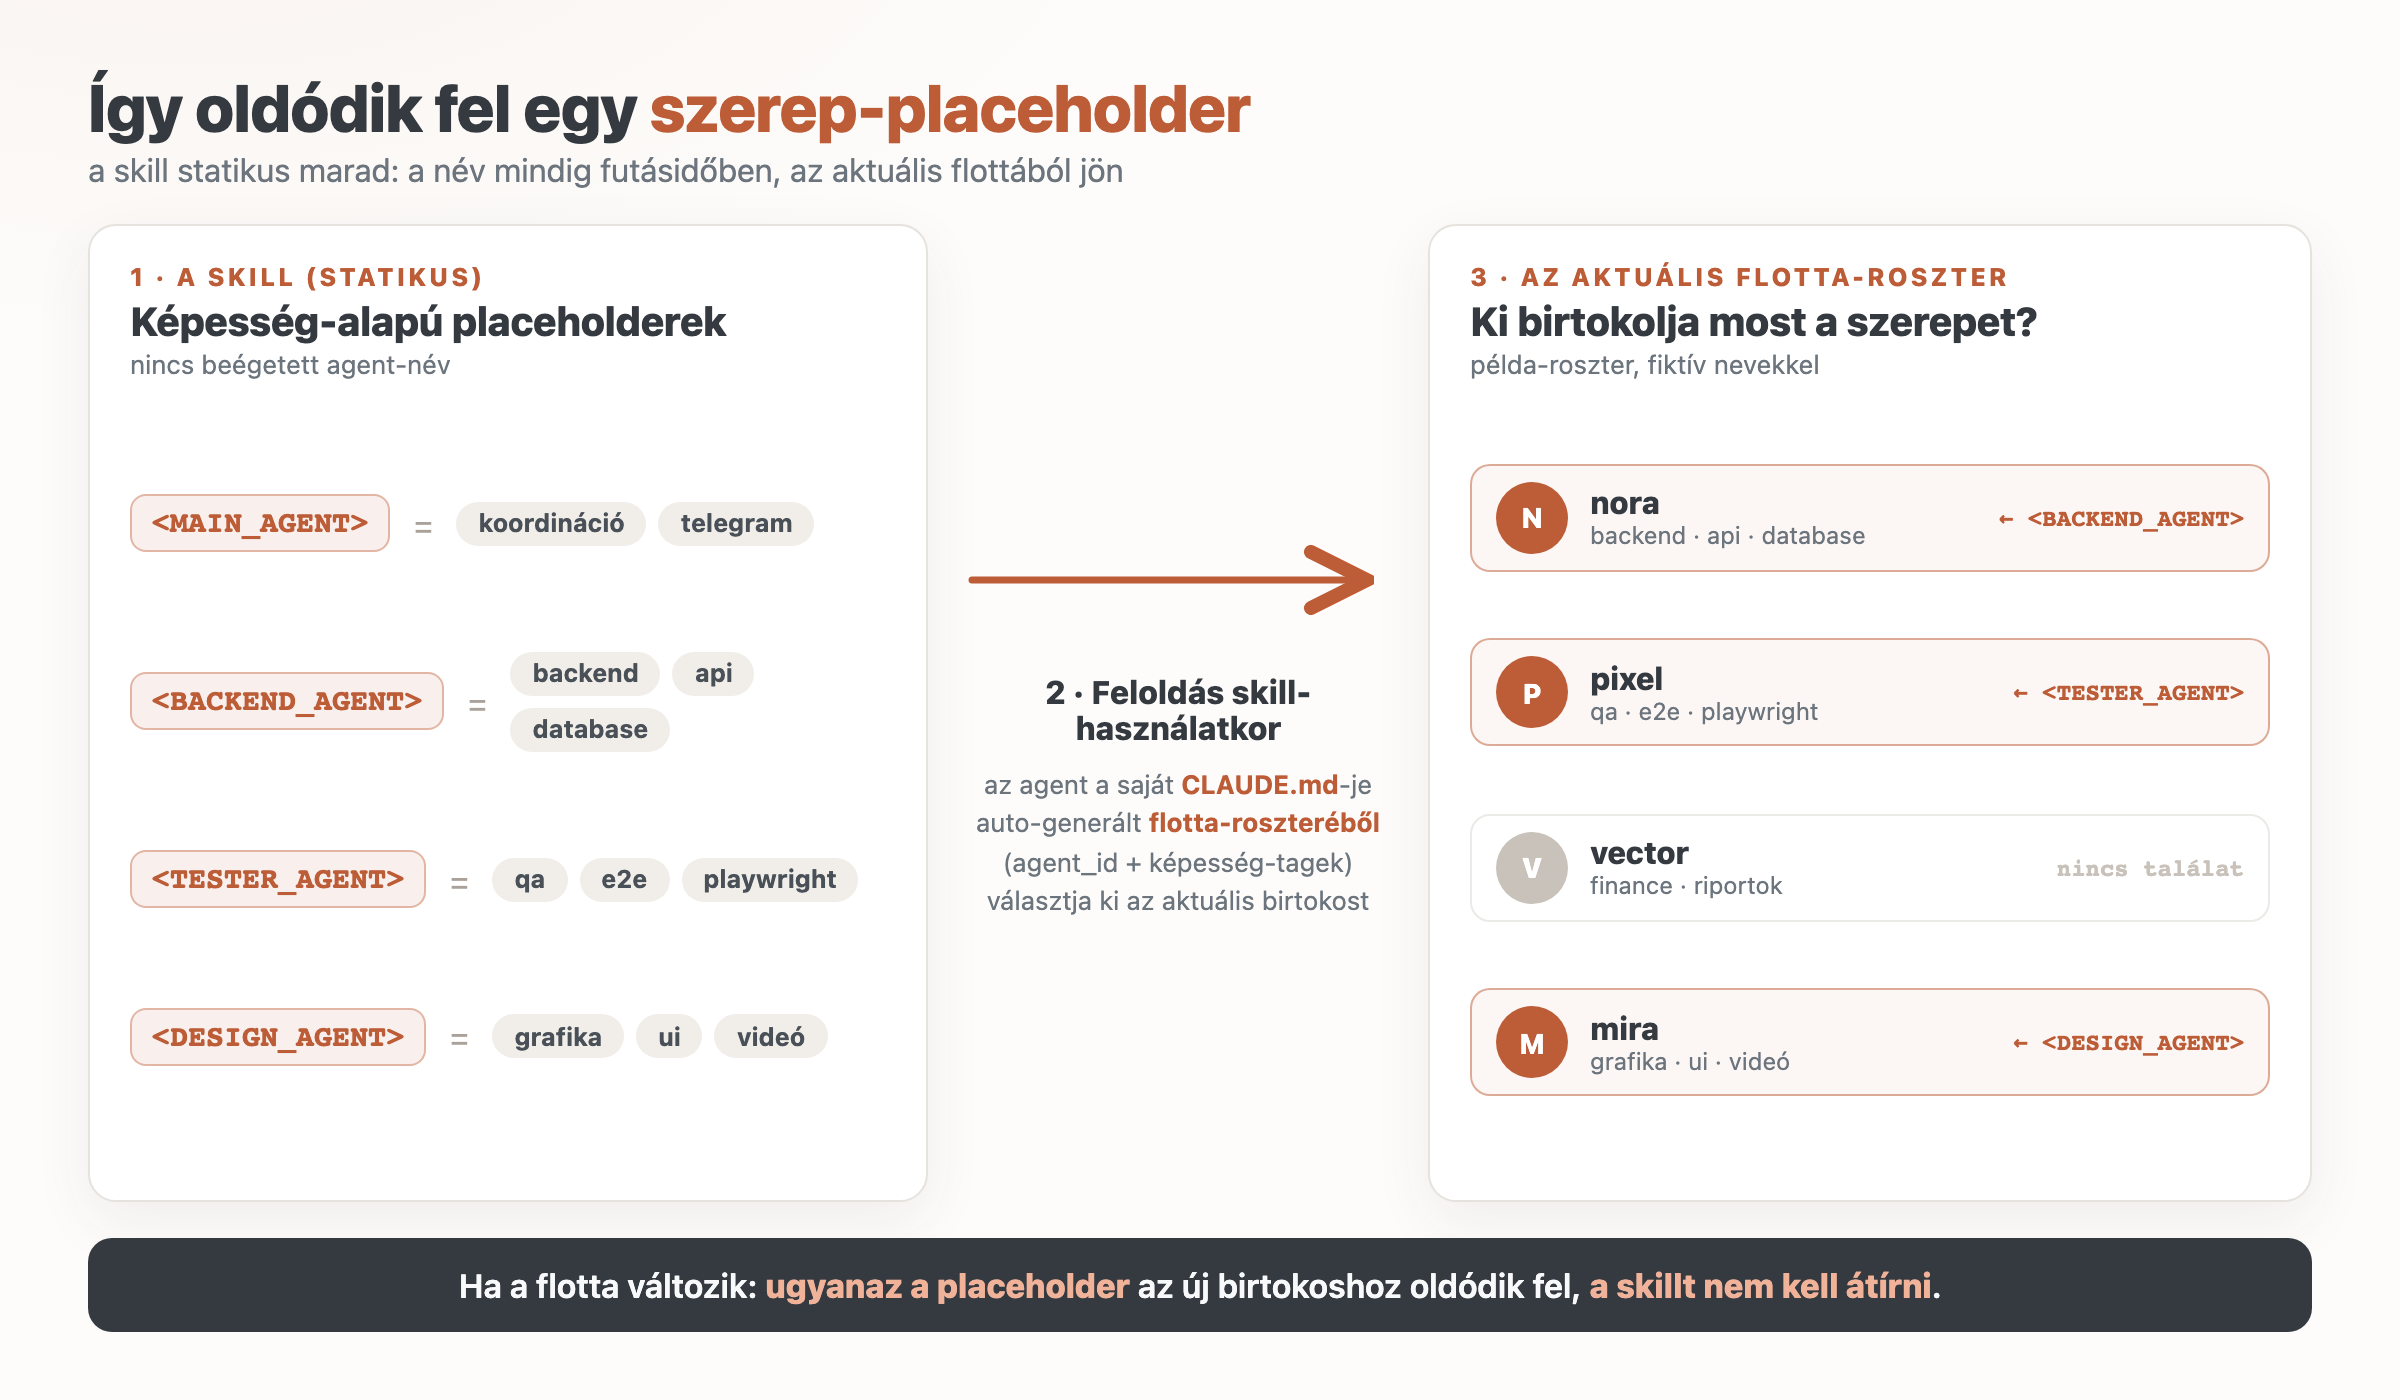
A kézenfekvő megoldás az lett volna, hogy a konkrét nevet egy másik, semleges névre cseréljük. Ezt szándékosan elkerültem. Az ügynök-nevek lényegében véletlenszerű azonosítók, a valódi jelentést a képességek hordozzák: backend, tesztelés, vizuális tervezés, és így tovább. Ha a Zack helyére <BACKEND_AGENT> kerül, a skill nem azt mondja ki, hogy "ez a konkrét személy kell", hanem azt, hogy "olyan ügynökre van szükségem, aki a backend-hez ért". Ez az egyetlen olyan feloldási alap, amely átnevezésnél, cserénél és egy teljesen új flottában is érvényes marad.
Van ennek egy kevésbé nyilvánvaló haszna is. A képesség-alapú helyettesítő a jövőbeli olvasót is megvédi a téves következtetéstől. A konkrét név azt sugallná, hogy "ez mindig arra az egy ügynökre vonatkozik". A szerep-alapú helyettesítő ezzel szemben pontosan azt közli, ami a szándék volt: itt egy adott képességű ügynökre van szükség, bárki is legyen az éppen.
3.2 A két réteg: statikus szótár, dinamikus feloldás
A rendszer két rétegből áll, és a hordozhatóság kulcsa éppen ez a kettősség. Az első réteg egy statikus szótár: kilenc szerep-alapú helyettesítő (például <BACKEND_AGENT>, <TESTER_AGENT>, <DESIGN_AGENT>), plusz egy önhivatkozás (<AGENT>) és egy az orchestrátorra mutató (<MAIN_AGENT>). Ez a szótár tervezéskor kerül a skillbe, és nem függ attól, ki van éppen a flottában.
A második réteg dinamikus. Amikor egy ügynök ténylegesen használ egy skillt, a helyettesítőt a saját konfigurációjából oldja fel. Minden ügynök leírásában van egy automatikusan generált flotta-jegyzék, amely felsorolja az ügynököket a képesség-címkéikkel együtt, és ez a jegyzék minden induláskor frissül. A skill betöltője ebből keresi ki, melyik éppen futó ügynök rendelkezik a kért képességgel. Nincs külön leképezési tábla, nincs kézzel karbantartott hozzárendelés: maga a flotta-jegyzék az igazságforrás. Ha egy ügynök cserélődik vagy nevet vált, a skill szövegéhez nem kell hozzányúlni, csak a jegyzék frissül a következő induláskor.
4. A migráció: 168 csere, mérhető nulla
4.1 A script: próbafutás, alkalmazás, ellenőrzés
A meglévő skillek megtisztítására külön migrációs szkriptet írattam. Három szempont vezette a tervezését. Az első a kontextus-érzékenység: ugyanaz a szó a skill más-más pontján mást jelent. Egy hibapélda illusztrációjában illusztrációs szereplő, egy eljárás lépésében szerep-helyettesítő, a leíró metaadatban egyszerű szöveg, a skill saját nevében pedig önazonosság, amelyhez sosem szabad hozzányúlni. A szkriptnek ezeket meg kellett tudnia különböztetni.
A második az idempotencia: a szkript kétszer lefuttatva sem végez kétszeres cserét, tehát biztonságosan megismételhető. A harmadik a mérhetőség. Az ellenőrző mód szándékosan csak a hatókörbe tartozó hivatkozásokat számolja, az önazonosságot kizárja belőle. Így a "nulla maradék" nem egy megszépített szám, hanem őszinte nulla: a megosztott skillekben és a kereszt-hivatkozásokban valóban nem maradt beégetett ügynök-név. A folyamat három lépése: próbafutás, alkalmazás mentéssel, majd ellenőrzés. A végeredmény 168 csere volt 51 fájlban.
4.2 Él-esetek és döntési elvek
Néhány eset nem fért bele a "cseréld a nevet" szabályba, és ezekre külön döntés kellett. Három kategória rajzolódott ki:
- Rendszer-azonosító. Egy skill a dashboard újraindítási parancsában egy valódi macOS szolgáltatás-címkét használ (
com.jarvis.dashboard). Ebben a névrészlet nem ügynök-hivatkozás, hanem a lemezen létező szolgáltatás azonosítója. Ha helyettesítővel cseréltük volna, a parancs érvénytelenné és használhatatlanná vált volna. Ez kimarad a cseréből, de az ellenőrző kimenetben külön, dokumentált kivételként jelenik meg, hogy a nulla átlátszó maradjon. - Önazonosság. Ha egy ügynök saját skilljének a neve tartalmazza a saját nevét, az identitás, nem kereszt-hivatkozás. Ezekhez nem nyúltunk.
- Kereszt-hivatkozás. Ahol egy skill egy másik ügynökre hivatkozik, akár egy fájl szerzőjeként is, ott a név valódi hivatkozás, tehát szerep-helyettesítő lett belőle. A hivatkozott fájlnév maga változatlan maradt.
A vezérlő elv egyszerű lett: az ügynök-név mint hivatkozás mindig csere, a rendszer-azonosító, a fájlnév vagy a konfigurációs kulcs mint literál pedig marad.
5. Üzemeltetői nézőpont: mit ér a hordozhatóság?
Érdemes kilépni a kódból, és megnézni, mit jelent ez üzemeltetési szempontból. Nagyvállalati IT-ben a katasztrófa-tűrési terv alapkövetelménye, hogy az eljárások ne kötődjenek konkrét gépnevekhez. Éppen ezért használunk szervizfiókot, DNS-aliast és terheléselosztót. A flottánál ugyanez a helyzet: ha egy ügynök kiesik, és egy másik veszi át a feladatát, a skillt nem kell módosítani, elég a flotta-jegyzék frissülése. Hardkódolt névvel a feladatátvétel kézzel szerkesztett skill-frissítést jelentene, egy éles incidens közepén ez elfogadhatatlan késleltetés.
A másik gyakorlati haszon a flották közötti újrahasznosíthatóság. Ha egy skill-készletet egy másik csapat szeretne átvenni, a beégetett nevek azonnali akadályt jelentenek: az átvevőnek nincs "Jarvis" nevű ügynöke, tehát minden skillt át kellene írnia. A helyettesítő-alapú skillek ezzel szemben importálhatók, és azonnal futtathatók, amint a fogadó fél megadta a saját, adott képességű ügynökét. Ez a különbség egy "csak nálunk működik" belső eszköz és egy valóban terjeszthető tudásbázis között.
6. A megelőzés: a constraint fontosabb a takarításnál
A migráció a múlt rendbetétele volt. A tartós eredményt viszont nem ez adja, hanem egy kis kiegészítés a skill-gyáramban. A skill-factory, amely az új skilleket állítja elő, kapott egy kötelező szakaszt az ügynök-nevek absztrakciójáról, és egy új ellenőrzési pontot a minőségi listájában: "nincs beégetett ügynök-név". Ezzel minden ezután készülő skillbe már a létrehozás pillanatában bekerül a helyettesítő-szabály, nincs szükség utólagos migrációra.
Ez a különbség egy egyszeri takarítás és egy tartós szabály között. A governance nyelvén szólva ez ugyanaz a mechanizmus, amit egy változáskezelési vagy architektúra-megfelelőségi kapu jelent: minden új elem bevitelekor automatikus ellenőrzés fut, hogy megfelel-e a szervezeti szabványnak. Nem ajánlás, hanem kapuőr. A szétválasztás a folyamatba van építve, nem a használó jószándékán múlik.
Őszinte leszek: utólag jólesett végigsöpörni a régi mintát, de ezt előre kellett volna megterveznem. A tanulság nem a takarítás, hanem a korlát. Migráció és migrációs szkript rendben van, de a migráció és a hozzá tartozó korlát az, ami nem engedi vissza a régi mintát.
7. Összefoglalás
| Szempont | Beégetett ügynök-név | Képesség-alapú helyettesítő |
|---|---|---|
| Ügynök átnevezése | Minden érintett skill kézi javítása | Nincs skill-változás, csak a jegyzék frissül |
| Szerepkör átadása | Beégetett név, félrevezető marad | Az aktuális képesség-tulajdonoshoz oldódik |
| Feladatátvétel (DR) | Kézi skill-frissítés incidens közben | Automatikus, a jegyzék dönt |
| Átvétel másik flottába | Minden skillt át kell írni | Importálható, azonnal futtatható |
| Önleíró jelleg | "Ki csinálja" látszik | "Milyen képesség kell" látszik |
| Feloldás helye | A skill szövegében rögzítve | A skill betöltőjében, futásidőben |
| Új skill létrehozása | A használó belátásán múlik | Skill-factory kapuőr kényszeríti |
| Migráció mérhetősége | Nincs | Hatókör-alapú ellenőrzés, őszinte nulla |
A változtatás mérete csekély: néhány helyettesítő, egy migrációs szkript, egy kiegészítés a skill-gyárban. A következménye viszont pont az, amit egy jól megtervezett absztrakciótól várok. A skilljeim mostantól kevesebb nevet ismernek, és éppen ettől lettek hordozhatóbbak. A hordozhatóság ugyanis nem egy funkció, amit hozzáadsz. Inkább valami, ami hiányzik, és akkor veszed észre, amikor átnevezed az egyik tagot.
A cikk a cett/marveen fork skill-rendszerének 2026-08-19-i állapotát tükrözi.
Van kérdésed, vagy beszélgetnél a témáról? Írj emailben: info@jonasgergo.hu, vagy keress meg LinkedInen.
English version
An automated workflow is more portable the fewer names it knows. That sentence ran through the whole development I write about here: I took the hard-coded agent names out of the skill set of my own AI fleet and replaced them with capability-based placeholders that are resolved at runtime. The end result is technically tiny, but its consequence is not: from now on the skills survive an agent being renamed or replaced, and can even be carried over into another fleet.
1. The problem: a hard-coded name as fragility
The agents of my fleet work from a shared skill set: these are reusable procedure descriptions that say how to carry out a recurring task. Many of these skills contained concrete agent names. They said things like "this step is done by Jarvis", or "hand the backend part to Zack". As long as nothing changes, this works perfectly well.
The trouble starts when something changes. An agent is renamed, a role is handed over, the fleet is reorganised, and suddenly every skill into which I had hard-coded that agent's name needs fixing. In my case there were 168 such places in 51 files. That is 168 possible points of failure for a single rename. This is a classic anti-pattern well known from traditional IT: configuration in code. If a script contains a concrete server name, an IP address or a user, then that script requires manual intervention at every change of environment. The skill set had built up the same debt, only in agent names.
In my reading, a hard-coded name is not a style flaw but an operational risk. A piece of documentation that refers to the name of an agent running today becomes misleading tomorrow, after the agent is renamed. A skill as a knowledge base is worth something only as long as the intent described in it stays valid independently of the name.
2. The analogy: interface and implementation
The solution is not a new idea, only the transfer of a well-known programming principle to another layer. A well-written function does not know exactly which database it calls. It knows that it needs a database that has a given capability. The interface is separated from the concrete implementation behind it. The same pattern appears in environment-independent operations: a deployment pipeline does not contain an environment-specific value, but a service registry or an environment variable resolves it at run time. The twelve-factor app methodology states this as a strict separation of config from code.
My skills used to stand on the wrong side: they called a concrete name. The aim was to move them to the right side: the "what has to be done" (the logic of the skill) should be separated from the "who does it" part (the current composition of the fleet). In software development this separation is called dependency injection. In my case the "dependency" is an agent role.
3. Capability-based placeholders
3.1 Why a capability and not a name?
The obvious solution would have been to replace the concrete name with another, neutral name. I deliberately avoided this. Agent names are essentially random identifiers; the real meaning is carried by capabilities: backend, testing, visual design and so on. If Zack is replaced by <BACKEND_AGENT>, the skill does not state that "this particular person is needed" but that "I need an agent who understands the backend". This is the only basis of resolution that stays valid when an agent is renamed or replaced, and in a completely new fleet.
There is a less obvious benefit as well. A capability-based placeholder also protects the future reader from a wrong conclusion. A concrete name would suggest that "this always refers to that one agent". A role-based placeholder, by contrast, says exactly what the intent was: an agent with a given capability is needed here, whoever it happens to be.
3.2 The two layers: a static dictionary, dynamic resolution
The system consists of two layers, and the key to portability is exactly this duality. The first layer is a static dictionary: nine role-based placeholders (for example <BACKEND_AGENT>, <TESTER_AGENT>, <DESIGN_AGENT>), plus a self-reference (<AGENT>) and one pointing to the orchestrator (<MAIN_AGENT>). This dictionary goes into the skill at design time and does not depend on who is in the fleet at the moment.
The second layer is dynamic. When an agent actually uses a skill, it resolves the placeholder from its own configuration. In every agent's description there is an automatically generated fleet register that lists the agents together with their capability labels, and this register is refreshed at every start. The skill loader looks up in it which currently running agent has the requested capability. There is no separate mapping table and no hand-maintained assignment: the fleet register itself is the source of truth. If an agent is replaced or changes name, the text of the skill need not be touched, only the register is refreshed at the next start.
4. The migration: 168 replacements, a measurable zero
4.1 The script: dry run, apply, verify
For cleaning up the existing skills I had a separate migration script written. Three considerations guided its design. The first is context sensitivity: the same word means something different at different points of a skill. In the illustration of an error it is an illustrative character, in a step of a procedure a role placeholder, in the descriptive metadata plain text, and in the skill's own name an identity that must never be touched. The script had to be able to tell these apart.
The second is idempotence: run twice, the script does not replace twice, so it can be safely repeated. The third is measurability. The verification mode deliberately counts only the references within scope and leaves self-identity out of it. This way the "zero remaining" is not a prettified number but an honest zero: in the shared skills and the cross-references no hard-coded agent name was really left. The process has three steps: a dry run, application with a backup, then verification. The end result was 168 replacements in 51 files.
4.2 Edge cases and decision principles
A few cases did not fit into the "replace the name" rule, and these needed a separate decision. Three categories emerged:
- System identifier. In the restart command of the dashboard, one skill uses a real macOS service label (
com.jarvis.dashboard). The name fragment in it is not an agent reference but the identifier of a service existing on disk. Had I replaced it with a placeholder, the command would have become invalid and unusable. This is left out of the replacement, but appears separately in the verification output as a documented exception, so that the zero stays transparent. - Self-identity. If the name of an agent's own skill contains its own name, that is identity, not a cross-reference. I did not touch these.
- Cross-reference. Where a skill refers to another agent, even as the author of a file, the name is a real reference there, so it became a role placeholder. The referenced file name itself stayed unchanged.
The guiding principle turned out simple: an agent name as a reference is always replaced, while a system identifier, a file name or a configuration key as a literal stays.
5. The operator's view: what is portability worth?
It is worth stepping out of the code and looking at what this means from an operations point of view. In large-enterprise IT, a basic requirement of the disaster-recovery plan is that procedures are not tied to concrete machine names. That is exactly why we use service accounts, DNS aliases and load balancers. In the fleet the situation is the same: if an agent drops out and another takes over its task, the skill need not be modified, it is enough for the fleet register to refresh. With a hard-coded name, failover would mean a hand-edited skill update, and in the middle of a live incident that is an unacceptable delay.
The other practical benefit is reusability between fleets. If another team wants to take over a skill set, the hard-coded names are an immediate obstacle: the recipient has no agent called "Jarvis", so they would have to rewrite every skill. Placeholder-based skills, by contrast, can be imported and run straight away, as soon as the receiving side has named its own agents of the given capability. This is the difference between an "only works for us" internal tool and a knowledge base that can genuinely be distributed.
6. Prevention: the constraint matters more than the cleanup
The migration was the tidying of the past. The lasting result, however, does not come from that but from a small addition to my skill factory. The skill factory, which produces new skills, got a mandatory section on the abstraction of agent names, and a new checkpoint in its quality list: "no hard-coded agent name". With this, the placeholder rule goes into every skill made from now on at the moment of creation, and no later migration is needed.
This is the difference between a one-off cleanup and a lasting rule. In the language of governance, this is the same mechanism as a change-management or architecture-compliance gate: whenever a new element is brought in, an automatic check runs on whether it meets the organisational standard. Not a recommendation, but a gatekeeper. The separation is built into the process, it does not depend on the good intentions of the user.
To be honest: looking back, it felt good to sweep away the old pattern, but I should have planned this in advance. The lesson is not the cleanup but the constraint. A migration script is fine, but what keeps the old pattern out is the constraint that goes with it.
7. Summary
| Aspect | Hard-coded agent name | Capability-based placeholder |
|---|---|---|
| Renaming an agent | Manual fix of every affected skill | No skill change, only the register is refreshed |
| Handing over a role | A hard-coded name, stays misleading | Resolves to the current holder of the capability |
| Failover (disaster recovery) | Manual skill update during an incident | Automatic, the register decides |
| Taking over into another fleet | Every skill has to be rewritten | Importable, runnable at once |
| Self-describing nature | "Who does it" is visible | "What capability is needed" is visible |
| Place of resolution | Fixed in the text of the skill | In the skill loader, at run time |
| Creating a new skill | Depends on the user's judgement | Enforced by the skill-factory gatekeeper |
| Measurability of the migration | None | Scope-based verification, an honest zero |
The size of the change is small: a few placeholders, a migration script, an addition to the skill factory. Its consequence, however, is exactly what I expect from a well-designed abstraction. My skills now know fewer names, and that is exactly what made them more portable. Portability is not a feature that you add. It is rather something whose absence you notice when you rename one of the agents.
This article reflects the state of the skill system of the cett/marveen fork on 19 August 2026.
Do you have a question, or would you like to talk about the topic? Write to me by email: info@jonasgergo.hu, or find me on LinkedIn.